Proxmox
Proxmox Ceph: installare e configurare Ceph su Proxmox VE
Proxmox Ceph è lo storage distribuito Ceph integrato in Proxmox VE: i dischi dei nodi del cluster diventano un unico storage condiviso e replicato, senza SAN. Servono almeno tre nodi, una rete dedicata da 10 Gbps in su e dischi enterprise; si installa con pveceph, poi si creano monitor, OSD e un pool a tre copie.
Rackone · 14 min di lettura
In questo articolo
Cos'è Proxmox Ceph e quando conviene?
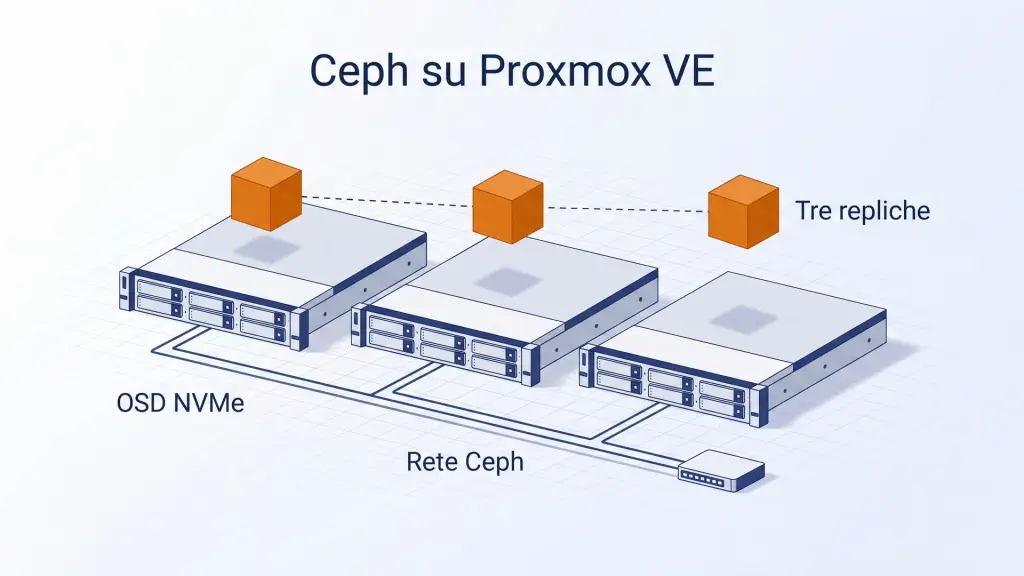
Ceph è uno storage distribuito open source che Proxmox VE installa e gestisce direttamente sui nodi del cluster: ogni server esegue macchine virtuali e destina i propri dischi a un pool condiviso e replicato. È l'architettura iperconvergente descritta nella guida di Proxmox VE: fa a meno della SAN, e la gestisci dalla stessa interfaccia web di Proxmox VE e dal comando pveceph.
Con Ceph lo storage è condiviso fra tutti i nodi: la live migration di una macchina virtuale non copia i dischi, e l'alta disponibilità la riavvia su un altro nodo con i dati aggiornati. La replica ZFS integrata, l'alternativa senza storage condiviso, copia i dischi a intervalli: secondo la documentazione della replica, con l'alta disponibilità si possono perdere i dati scritti dopo l'ultima sincronizzazione.
Per Ceph servono almeno tre server, una rete dedicata e dischi adatti. Per una sede con due server la scelta tipica resta la replica ZFS con un QDevice, descritta nella pagina sul cluster Proxmox a 2 nodi. Architettura, dimensionamento e confronto con Nutanix e vSAN sono nella pagina su Proxmox HCI e iperconvergenza.
Quanti nodi e quanti OSD servono?
Un cluster Proxmox VE con Ceph richiede almeno tre server, preferibilmente identici: la guida di Proxmox VE raccomanda almeno tre nodi e almeno 12 OSD distribuiti in modo uniforme. Un OSD (Object Storage Daemon) è il servizio che gestisce un disco, e la guida consiglia un OSD per ogni disco fisico.
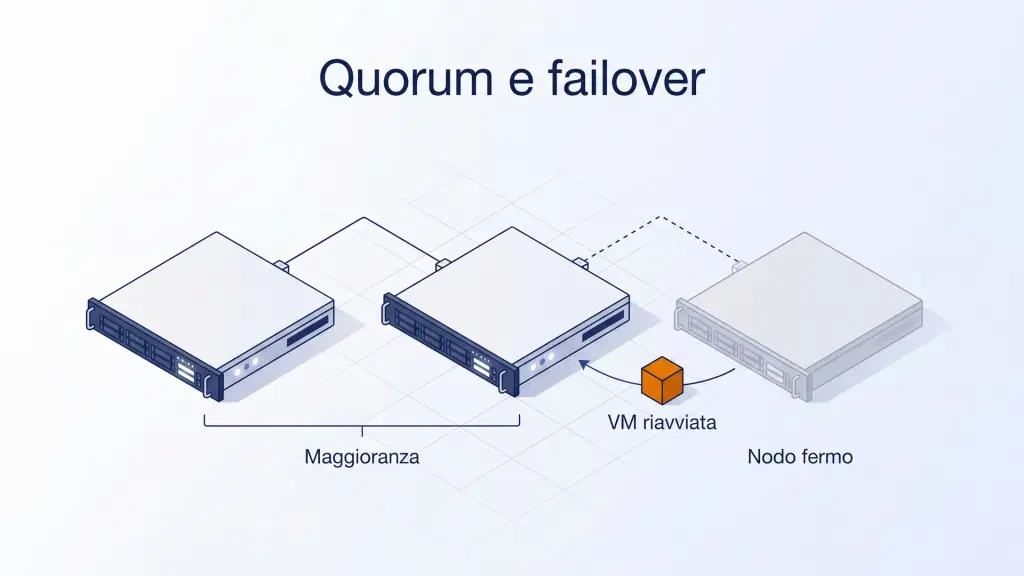
I monitor mantengono la mappa del cluster e formano il quorum di Ceph: ne servono almeno tre, e per un cluster piccolo o medio tre bastano. Il manager è in esecuzione sugli stessi nodi dei monitor e gestisce funzioni come l'autoscaling dei placement group e il controllo dello stato dei dischi: ne è attivo uno alla volta, e un secondo resta di riserva.
Su tre nodi un pool a tre copie non ha un quarto host dove ricostruire la copia di un nodo fuori linea: i dati restano con due copie finché il nodo non torna in linea. Succede perché, con il failure domain host usato di solito, ogni replica di un oggetto è memorizzata su un host diverso, come spiega la documentazione di Ceph sulle mappe CRUSH. Da quattro nodi in su Ceph può ricostruire la terza copia sugli altri, se c'è spazio libero. Il dimensionamento per numero di nodi è nella pagina sul cluster Proxmox multinodo.
Che rete serve a Ceph su Proxmox VE?
La rete di Ceph deve essere dedicata e veloce: la guida di Proxmox VE raccomanda almeno 10 Gbps riservati al traffico Ceph e, con dischi NVMe, almeno 25 Gbps, perché un solo NVMe può saturare un collegamento da 10 Gbps. Per cluster da tre a cinque nodi senza switch da 10 Gbps in su, la guida ammette anche la rete full mesh, con i nodi collegati direttamente fra loro: la procedura collegata descrive tre nodi e raccomanda gli switch per cluster più grandi o destinati a crescere.
Separa il traffico Ceph da quello di Corosync, il sistema di comunicazione del cluster Proxmox VE: la guida avverte che il traffico di un recovery interferisce con Corosync, che è sensibile alla latenza, e può far perdere il quorum del cluster. Per le installazioni ad alte prestazioni la guida consiglia tre reti fisiche. La prima, da 25 Gbps in su, è dedicata al traffico interno di Ceph. La seconda, da 10 Gbps in su, collega servizi Ceph e client e può trasportare anche il traffico delle macchine virtuali e delle migrazioni. La terza, da 1 Gbps, è riservata a Corosync.
Nella configurazione di Ceph la public network è obbligatoria e trasporta il traffico fra i servizi Ceph e i client, per esempio le macchine virtuali con dischi RBD. La cluster network è facoltativa: isola il traffico di replica e di heartbeat degli OSD, e si può spostare su un'altra rete fisica anche dopo l'installazione. Secondo le note di rilascio di Proxmox VE 9.0 (agosto 2025), le fabric SDN possono configurare anche la rete full mesh di un cluster Ceph.
Che hardware richiede Proxmox Ceph?
I requisiti di Ceph su Proxmox VE sono dischi enterprise collegati senza RAID, almeno un core per servizio e memoria riservata agli OSD. I valori che seguono sono tratti dalla guida di Proxmox VE e dalle raccomandazioni hardware di Ceph: adattali al workload del cluster.
Dischi. La documentazione di Ceph consiglia SSD di classe enterprise con protezione dalla perdita di alimentazione (PLP): gli SSD per desktop, dopo un primo picco, rallentano molto quando la cache si riempie. La guida di Proxmox VE indica dischi uguali e in numero uguale su ogni nodo, per esempio quattro dischi da 500 GB al posto di un disco da 1 TB più tre da 250 GB, e consiglia gli SSD nei cluster piccoli perché riducono la durata del recovery dopo un guasto.
Niente RAID. Ceph gestisce in autonomia ridondanza e scritture parallele sui dischi e, secondo la guida, un controller RAID non migliora prestazioni o disponibilità e a volte le peggiora. Al suo posto usa un HBA (host bus adapter), che espone direttamente i dischi a Ceph.
CPU. La documentazione di Proxmox VE prevede almeno un core o un thread per ogni servizio Ceph: un nodo con un monitor, un manager e sei OSD riserva 8 core al solo Ceph. Un OSD su un disco NVMe molto veloce può usare da quattro a sei thread.
Memoria. Il valore predefinito di osd_memory_target è 4 GiB, un obiettivo e non un limite rigido, ma la guida raccomanda almeno 8 GiB per ottenere buone prestazioni. Durante recovery e ribilanciamento il consumo cresce, quindi non saturare la RAM dei nodi già nel funzionamento normale. Alza il valore per tutti gli OSD con ceph config set osd osd_memory_target 8G.
Quale versione di Ceph installa Proxmox VE 9?
Proxmox VE 9.2 installa Ceph Tentacle 20.2 sui nodi che non hanno ancora Ceph, mentre i cluster esistenti restano sulla release che già usano, come riportano le note di rilascio del 21 maggio 2026. Proxmox VE 9.0 e 9.1 includono Ceph Squid 19.2.3.
| Proxmox VE | Uscita | Ceph nelle note di rilascio | Proposto sulle installazioni nuove |
|---|---|---|---|
| 9.0 | 5 agosto 2025 | Squid 19.2.3 | Squid |
| 9.1 | 19 novembre 2025 | Squid 19.2.3 | Squid |
| 9.2 | 21 maggio 2026 | Squid 19.2.3 e Tentacle 20.2.1 | Tentacle |
Per un cluster nuovo usa Tentacle, la release predefinita di Proxmox VE 9.2 (--version tentacle). Squid resta selezionabile con --version squid, ma la sua manutenzione da parte del progetto Ceph è prevista fino al 31 ottobre 2026: i cluster che lo usano vanno portati a Tentacle. Su un cluster che ha già Ceph, la procedura guidata propone la release in uso; su un cluster senza Ceph propone Tentacle. Il passaggio da Squid a Tentacle di un cluster in produzione segue la guida di aggiornamento ufficiale, con i riavvii dei servizi nell'ordine che indica.
Come si installa Ceph su Proxmox VE?
Per installare Ceph parti da un cluster Proxmox VE già creato, con la stessa versione su tutti i nodi e la rete Ceph configurata: la creazione del cluster è descritta nella pagina Cluster Proxmox e alta disponibilità. I comandi seguono la guida di Proxmox VE 9.2 e la pagina di manuale di pveceph consultate a ottobre 2026: prima di applicarli verifica la guida della release che installi.
Installa i pacchetti Ceph su ogni nodo. Il repository
enterprise, predefinito, è quello che Proxmox raccomanda per la produzione e richiede una sottoscrizione;no-subscriptionè gratuito e indicato per test e ambienti non produttivi;manuallascia i repository come sono, quindi prima devi configurarne uno con i pacchetti Ceph, per esempio un mirror interno.# su ogni nodo pveceph install # senza sottoscrizione pveceph install --repository no-subscriptionCrea la configurazione iniziale su un solo nodo, con la public network e, se c'è, la cluster network. Il file system del cluster, pmxcfs, replica il file
/etc/pve/ceph.confsu tutti i nodi.pveceph init --network 10.10.10.0/24 --cluster-network 10.10.20.0/24Crea un monitor su ciascuno dei tre nodi. Quando crei il primo monitor, Proxmox VE crea anche il primo manager.
# su tre nodi
pveceph mon create
Aggiungi un manager su un altro nodo con il monitor, come riserva.
pveceph mgr createCrea un OSD per ogni disco dedicato a Ceph, su ogni nodo. Se un disco è già stato usato per ZFS o come OSD, azzeralo prima: il comando di azzeramento cancella tutti i suoi dati.
# solo per un disco già usato
ceph-volume lvm zap /dev/sd[X] --destroy
pveceph osd create /dev/sd[X]
Crea il pool e lo storage per i dischi delle macchine virtuali, come nella sezione sui pool.
Dall'interfaccia web la sequenza è la stessa: nella sezione Ceph del nodo la procedura guidata installa i pacchetti e configura public network, cluster network e primo monitor; poi usi i pannelli Ceph → Monitor, Ceph → OSD e Ceph → Pools.
Con dischi lenti puoi spostare il database interno degli OSD (DB) e il suo log (WAL) su un SSD o un NVMe più veloce, con l'opzione -db_dev di pveceph osd create. Se non indichi le dimensioni, Proxmox VE usa i valori bluestore_block_db_size e bluestore_block_wal_size già configurati in Ceph e, se mancano, assegna al DB il 10% e a un WAL separato l'1% della dimensione dell'OSD; con il solo -db_dev il WAL sta sullo stesso dispositivo del DB. Un disco veloce condiviso da troppi OSD diventa il collo di bottiglia di tutti.
Come si creano il pool e lo storage RBD?
Un pool è il gruppo logico in cui Ceph memorizza gli oggetti, e su Proxmox VE diventa lo storage RBD dei dischi di macchine virtuali e container. Senza opzioni, secondo la guida di Proxmox VE, un pool viene creato con 128 placement group, size 3 e min_size 2: tre copie di ogni oggetto, con l'I/O che continua finché ne restano almeno due.
pveceph pool create vm-ceph --add_storages
Da riga di comando aggiungi l'opzione --add_storages: secondo la pagina di manuale di pveceph, per i pool replicati l'opzione è disattivata per impostazione predefinita, mentre nell'interfaccia web la casella Add as Storage è già spuntata. Senza l'opzione il pool esiste ma non compare fra gli storage di Proxmox VE, e devi aggiungerlo da Datacenter → Storage con il tipo RBD.
Non impostare min_size 1: la guida lo esclude in modo esplicito, perché un pool che accetta scritture con una sola copia può perdere dati o lasciare oggetti introvabili. L'autoscaler dei placement group è inizialmente configurato in modalità warn, che segnala un numero di placement group non ottimale senza cambiarlo; i parametri Target Ratio e Target Size orientano il calcolo del numero ottimale.
CephFS per ISO, template e backup
CephFS è il file system di Ceph, e Proxmox VE lo usa come storage condiviso per backup, immagini ISO e template dei container. Servono monitor, OSD e almeno un Metadata Server (MDS). La guida riporta che pveceph fs create crea un pool dati con 128 placement group e un pool di metadati con un quarto di quel numero, e aggiunge lo storage al cluster.
pveceph mds create
pveceph fs create --pg_num 128 --add-storage
Il Metadata Server attivo, con le impostazioni predefinite, è uno solo: gli altri MDS restano in standby e subentrano se quello attivo non è più disponibile.
Quanto spazio utile resta con tre copie?
Con size 3 lo spazio utile di un pool Ceph è un terzo dello spazio grezzo, e prima di riempirlo intervengono le soglie di occupazione degli OSD. Secondo la documentazione di Ceph, un OSD è nearfull all'85% di occupazione, non accetta più backfill al 90% e al 95% è full: a quel punto Ceph blocca le scritture e i servizi che dipendono dallo storage possono fermarsi. I valori effettivi del tuo cluster si leggono con ceph osd dump.
Un esempio di calcolo con quei valori: tre nodi con 10 TB grezzi ciascuno danno 30 TB grezzi, 10 TB utili con tre copie e circa 8,5 TB prima della soglia nearfull, se gli OSD si riempiono in modo uniforme. La documentazione di Ceph consiglia di sottrarre anche lo spazio degli OSD che si prevede di perdere insieme, perché dopo un guasto Ceph ricostruisce le repliche sugli OSD rimasti. Il calcolatore Ceph fa questo conto sul tuo cluster, con il guasto peggiore, le tre soglie e lo spazio di block.db.
Controlla l'occupazione di ogni OSD con ceph osd df tree, oppure nel pannello Ceph → OSD alla colonna Used (%). Prima di rimuovere un OSD, verifica che l'occupazione di tutti gli OSD sia ben al di sotto della soglia nearfull, come prescrive la guida di Proxmox VE, perché il ribilanciamento che segue può riempirli.
Come si verifica che Ceph funzioni?
Il comando ceph -s mostra lo stato di Ceph: per un cluster sano riporta HEALTH_OK, mentre con HEALTH_WARN e HEALTH_ERR il comando elenca i problemi e le operazioni in corso. La stessa vista è nel pannello Ceph di ogni nodo.
ceph -s
ceph osd df tree
ss -tulpn | grep ceph
Il comando ss, che la guida usa dopo un cambio di rete, mostra gli indirizzi su cui ascoltano i servizi Ceph: usalo per confermare che public network e cluster network siano quelle previste.
Errori comuni con Ceph su Proxmox VE
I problemi di Ceph più comuni, secondo la guida di Proxmox VE, derivano dalla rete (congestione, switch difettosi, firewall che bloccano), da dischi difettosi o lenti sotto carico e da hardware che non rispetta le raccomandazioni. Cerca nella tabella il sintomo: causa e soluzione sono tratte dalla guida e dalla documentazione di Ceph.
| Sintomo | Causa | Soluzione |
|---|---|---|
| Latenza alta sui dischi delle VM durante un recovery, a volte perdita del quorum del cluster | traffico Ceph sulla stessa rete di Corosync o delle VM | rete Ceph dedicata, Corosync su una rete propria |
| Il disco non si può usare per un OSD | metadati residui di ZFS o di un OSD precedente | ceph-volume lvm zap /dev/sd[X] --destroy, che cancella tutti i dati sul disco |
| Il pool creato da riga di comando non compare fra gli storage | --add_storages è falso per i pool replicati | non cancellare né ricreare il pool: aggiungi il pool esistente da Datacenter → Storage → Add → RBD, oppure con pvesm add rbd vm-ceph --pool vm-ceph --content images,rootdir |
| HEALTH_WARN con OSD nearfull | OSD oltre la soglia nearfull | aggiungi OSD o libera spazio prima della soglia full |
| I/O bloccato su alcuni placement group | meno copie disponibili di min_size, per esempio OSD riavviati su più host insieme | riavvia gli OSD un host alla volta e attendi HEALTH_OK |
| OSD down | disco o collegamento difettoso, problemi di rete | controlla log, stato del disco, collegamenti e rete; se gli OSD LVM ci sono ma sono inattivi prova ceph-volume lvm activate --all sul nodo; riavvia il nodo solo se è sicuro per il cluster, e ricrea o sostituisci l'OSD solo quando è accertato che serve |
| HEALTH_ERR con AUTH_INSECURE_SERVICE_KEY_TYPE dopo un aggiornamento | controlli sulle chiavi cephx aes introdotti con Ceph Squid 19.2.6 e Tentacle 20.2.4 | migrazione ad aes256k con lo strumento di Proxmox VE |
Il controllo AUTH_INSECURE_SERVICE_KEY_TYPE è stato introdotto con Ceph Squid 19.2.6 e Tentacle 20.2.4, rilasciate il 19 agosto 2026 per correggere la CVE-2025-30156, un aggiramento dell'autenticazione di CephX (annuncio del progetto Ceph). I nuovi controlli segnalano le chiavi che usano ancora il cifrario aes, e due di questi portano il cluster in HEALTH_ERR anche se lo storage funziona, come avverte la guida di Proxmox VE. Per migrare al tipo di chiave aes256k ti servono pve-manager 9.2.19 o successivo e lo strumento pve-cephx-rotate-service-keys, che prima mostra il piano e poi lo applica con --apply. I due comandi qui sotto migrano solo le chiavi dei servizi del cluster: prima aggiorna tutti i nodi, completa i riavvii progressivi dei servizi e risolvi gli altri errori, poi esegui lo strumento come root da un solo nodo, senza altre manutenzioni in corso. Per completare la migrazione verifica la compatibilità di tutti i client, ruota le loro chiavi, aggiorna le sessioni e solo alla fine restringi i cifrari, seguendo la guida ufficiale. Riavviare il sistema operativo dentro una macchina virtuale non aggiorna la chiave che usa QEMU.
# piano, senza modifiche
/usr/share/pve-manager/migrations/pve-cephx-rotate-service-keys --rotate-cluster-keys
# applicazione
/usr/share/pve-manager/migrations/pve-cephx-rotate-service-keys --rotate-cluster-keys --apply
Come si spegne un cluster Proxmox VE con Ceph?
Prima di spegnere un cluster Proxmox VE con Ceph ferma tutti i client e imposta il flag noout, così gli OSD spenti non vengono marcati out e Ceph non ridistribuisce i dati mentre i nodi si spengono e si riaccendono. La guida di Proxmox VE indica questa procedura:
- Ferma macchine virtuali, container e ogni altro client di Ceph, come i mount CephFS.
- Verifica con
ceph -sche il cluster sia sano. - Imposta il flag noout con
ceph osd set noout, così Ceph non ridistribuisce i dati degli OSD spenti. - Spegni prima i nodi senza monitor, poi quelli con i monitor.
- Alla riaccensione avvia prima i nodi con i monitor; quando tutti i servizi Ceph sono attivi e l'unico avviso rimasto riguarda
noout, rimuovi il flag conceph osd unset nooute avvia le macchine virtuali.
Le macchine virtuali in alta disponibilità fermate da Proxmox VE passano allo stato stopped e tornano allo stato started quando le avvii. Per la manutenzione lavora su un nodo alla volta e aspetta HEALTH_OK prima di passare al successivo.
Progettare il cluster Ceph con Rackone
Per un cluster Proxmox VE con Ceph verifica prima nodi, rete e dischi: almeno tre nodi, preferibilmente identici, una rete Ceph dedicata e separata da Corosync, dischi enterprise su HBA. Poi installa i pacchetti, crea la configurazione, tre monitor, gli OSD e un pool a tre copie. Dopo l'installazione mantieni l'occupazione di ogni OSD sotto la soglia nearfull ed esegui la manutenzione su un nodo alla volta.
Rackone è Proxmox Gold Partner e Proxmox Authorized Training Partner. Per un cluster Proxmox VE con Ceph progettiamo la topologia, lo storage, la segregazione delle reti, l'hardware, l'alta disponibilità e i backup, e consegniamo il progetto documentato prima dell'installazione. Per l'hardware in sede forniamo anche server Proxmox preconfigurati.
Scritto da Rackone