Proxmox
Configurare un cluster Proxmox VE: quorum, HA e failover
Un cluster Proxmox VE è un gruppo di server che condividono configurazione e stato tramite Corosync e riavviano le macchine virtuali su un nodo sano quando uno si guasta. Per l'alta disponibilità servono almeno tre voti, una rete di cluster con latenza sotto i 5 millisecondi e uno storage condiviso; i comandi pvecm e ha-manager gestiscono la configurazione.
Rackone · 8 min di lettura
In questo articolo
Quanti nodi servono a un cluster Proxmox?
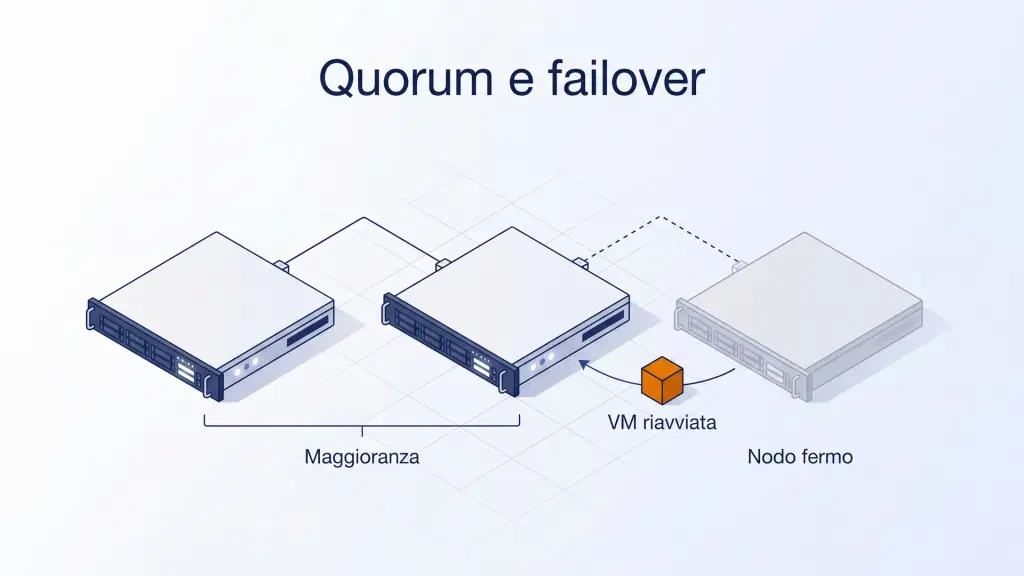
Un cluster Proxmox con alta disponibilità richiede almeno tre voti, cioè tre nodi oppure due nodi con un QDevice esterno, perché il quorum si calcola a maggioranza e con tre voti il cluster sopravvive alla perdita di un server. La documentazione del Cluster Manager indica tre nodi come minimo per un quorum affidabile e raccomanda la stessa versione di Proxmox VE su tutti.
Dal numero di nodi dipende quanti guasti il cluster tollera. Un numero pari non aggiunge tolleranza: quattro nodi resistono a un guasto come tre, con un server in più da gestire.
| Nodi | Voti per il quorum | Guasti tollerati | Quando ha senso |
|---|---|---|---|
| 2 | 2 (2 su 3 con QDevice) | nessuno (1 con QDevice) | sedi piccole, solo con un QDevice esterno |
| 3 | 2 | 1 | il minimo per la produzione con HA |
| 4 | 3 | 1 | crescita di capacità, non di tolleranza |
| 5 | 3 | 2 | workload critici, manutenzione anche con un nodo già fermo |
Oltre i cinque nodi contano soprattutto la rete di cluster e lo storage: il dimensionamento è descritto nella pagina sul cluster Proxmox multinodo.
Il cluster a due nodi e il QDevice
Un cluster Proxmox a due nodi perde il quorum appena un nodo va offline, perché il nodo rimasto dispone di un voto su due. La soluzione prevista da Proxmox è il QDevice: un servizio esterno, corosync-qnetd, installato su un terzo host anche piccolo, che fornisce il voto mancante. L'architettura completa è descritta nella pagina sul cluster Proxmox a 2 nodi.
# sull'host esterno al cluster
apt install corosync-qnetd
# su tutti i nodi del cluster
apt install corosync-qdevice
# da un nodo del cluster
pvecm qdevice setup <IP-DEL-QDEVICE>
Il QDevice non è un nodo del cluster: corosync-qnetd assegna il proprio voto a una sola partizione alla volta, quella che con quel voto raggiunge la maggioranza. Se i due nodi non comunicano più via Corosync ma raggiungono entrambi il QDevice, solo uno dei due ottiene il voto e mantiene il quorum. A differenza di Corosync, il QDevice si collega via TCP/IP e non è vincolato alla bassa latenza: può essere eseguito fuori dalla LAN del cluster, per esempio in un'altra sede.
In uno stretched cluster con Ceph, distribuito su due sedi, il QDevice non basta: la wiki Proxmox sullo Stretch Cluster prevede in una terza sede un nodo tie-breaker Proxmox VE, che fornisce a Corosync il voto decisivo e ospita un monitor Ceph per lo spareggio dello storage. Con due sedi senza Ceph, per esempio con la replica ZFS, il terzo voto serve solo a Corosync e può essere un QDevice.
Con un numero dispari di nodi la documentazione sconsiglia il QDevice: in quel caso fornisce N-1 voti e, se il QDevice si guasta, basta la perdita di un solo nodo perché il cluster perda il quorum.
Come funziona il quorum in Proxmox VE?
Il quorum è la maggioranza dei voti che un cluster Proxmox VE deve ottenere per modificare il proprio stato: ogni nodo vale un voto e, senza maggioranza, il cluster passa in modalità sola lettura. È la protezione contro lo split-brain, la situazione in cui due parti isolate del cluster operano in modo indipendente sugli stessi dischi.
Il quorum governa pmxcfs, il file system del cluster montato in /etc/pve che replica su tutti i nodi le configurazioni delle macchine virtuali, dello storage e degli utenti. Senza quorum:
- la configurazione in
/etc/pvenon si può modificare; - non si avviano, non si creano e non si migrano macchine virtuali;
- i nodi con risorse HA attive lasciano scadere il watchdog e, secondo la documentazione HA, si riavviano dopo 60 secondi.
Le macchine virtuali già accese sui nodi senza HA restano in esecuzione. Per vedere voti, nodi e stato del quorum usa pvecm status.
Che rete serve a Corosync?
Corosync, il motore di comunicazione del cluster Proxmox VE, usa poca banda ma richiede una latenza bassa e costante. La documentazione indica una latenza sotto i 5 millisecondi fra tutti i nodi, cioè prestazioni da rete locale. Una scheda dedicata da 1 Gbit basta nella maggior parte dei casi. Per questo separa la rete di cluster da quella delle macchine virtuali, dello storage e delle migrazioni: un backup o una migrazione che saturano il collegamento causano la perdita dei messaggi di Corosync, e un nodo che non risponde viene escluso.
Prima di creare il cluster verifica i requisiti indicati dalla documentazione del Cluster Manager:
- porte UDP da 5405 a 5412 aperte fra tutti i nodi, più SSH sulla porta TCP 22;
- data e ora sincronizzate su ogni nodo;
- un secondo link Corosync su una rete fisica diversa, così il cluster rimane operativo se il primo link si interrompe;
- niente bond come unico link di cluster: in alcuni scenari di guasto non garantisce la ridondanza attesa.
Le note di rilascio di Proxmox VE 9.2 (maggio 2026) riportano che i cluster nuovi vengono creati con un token coefficient di 125 millisecondi, che accorcia la ricostruzione del cluster dopo il guasto di un nodo. Sui cluster esistenti verifica i requisiti di latenza prima di abbassarlo, come indica la documentazione.
Come si crea un cluster Proxmox VE?
Per creare un cluster Proxmox VE ti servono nodi già installati con il nome host e l'indirizzo IP definitivi, perché dopo la creazione del cluster non si possono più cambiare. Il nodo che entra nel cluster non deve contenere macchine virtuali, perché la sua configurazione in /etc/pve viene sovrascritta.
Installa la stessa versione di Proxmox VE su tutti i nodi e verifica la sincronizzazione dell'ora.
Sul primo nodo crea il cluster, indicando i due link Corosync:
pvecm create NOMECLUSTER --link0 10.10.10.1 --link1 10.20.20.1Su ogni nodo da aggiungere esegui
pvecm add, indicando l'indirizzo del primo nodo e gli indirizzi locali dei due link. Serve la password di root del nodo già nel cluster.pvecm add 10.10.10.1 --link0 10.10.10.2 --link1 10.20.20.2Controlla il risultato con
pvecm status(voti e quorum) epvecm nodes(elenco dei membri).
Dall'interfaccia web la procedura è la stessa: in Datacenter → Cluster usa Create Cluster sul primo nodo, poi Join Information per copiare i dati di adesione e Join Cluster sugli altri.
Come si configura una macchina virtuale in alta disponibilità?
L'alta disponibilità di Proxmox VE riavvia una macchina virtuale su un altro nodo quando il suo nodo si guasta. Per farlo il disco della macchina deve essere accessibile da tutti i nodi: storage condiviso come Ceph, NFS o iSCSI, oppure la replica ZFS integrata, che però è asincrona: al failover la VM riparte dall'ultima replica completata e perde le modifiche successive. Le architetture con Ceph integrato sono descritte nella pagina su Proxmox HCI e iperconvergenza.
Aggiungi una risorsa all'HA da Datacenter → HA oppure da riga di comando:
ha-manager add vm:100 --state started --max_restart 1 --max_relocate 1
ha-manager status
Prima di riavviare la macchina su un altro nodo, il cluster deve accertare che il nodo guasto non scriva più sui dischi. Il fencing di Proxmox VE usa un watchdog: se il nodo perde il quorum, il timer scade dopo 60 secondi e il server si riavvia. Secondo la documentazione HA, rilevamento e failover richiedono di solito circa due minuti: è un riavvio, non una live migration.
Regole HA al posto dei gruppi
Dalla versione 9.0 Proxmox VE sostituisce i gruppi HA con le regole HA, salvate in /etc/pve/ha/rules.cfg; i gruppi esistenti vengono convertiti in regole di node affinity. Una regola di node affinity indica i nodi su cui eseguire di preferenza una risorsa, e con --strict 1 la vincola a quei nodi. Una regola di resource affinity stabilisce se due risorse devono essere eseguite sullo stesso nodo o su nodi diversi, per esempio i due nodi di un database replicato, che non devono mai essere in esecuzione sullo stesso server.
ha-manager rules add node-affinity ha-rule-vm100 --resources vm:100 --nodes node1
ha-manager rules set node-affinity ha-rule-vm100 --strict 1
ha-manager rules add resource-affinity db-separati --affinity negative --resources vm:201,vm:202
Cosa succede quando si spegne un nodo?
La politica di shutdown stabilisce come l'HA di Proxmox VE gestisce le risorse di un nodo che viene spento o riavviato. La imposti da Datacenter → Options → HA Settings o in datacenter.cfg, e la predefinita è Conditional per compatibilità con le versioni precedenti. La documentazione HA aggiunge che per molti amministratori Migrate è il comportamento più vicino a quello che si aspettano.
| Politica | Cosa succede alle risorse HA del nodo |
|---|---|
| Conditional (predefinita) | allo spegnimento si arrestano e si riavviano su altri nodi; al riavvio restano congelate finché il nodo non torna operativo |
| Migrate | migrano su altri nodi prima dello spegnimento |
| Failover | si arrestano e vengono recuperate su altri nodi se il nodo non torna operativo in tempi brevi |
| Freeze | si arrestano e restano congelate finché il nodo non torna operativo |
Con Conditional lo spegnimento arresta le macchine virtuali e le riavvia su altri nodi, senza live migration: se vuoi eseguire una live migration, avviala a mano prima di spegnere il nodo, oppure scegli Migrate.
Come si fa manutenzione senza far scattare il fencing?
Prima di lavorare su un nodo Proxmox VE in alta disponibilità attiva la modalità manutenzione: il cluster migra le risorse HA sugli altri nodi secondo le regole e lo scheduler. Puoi eseguire il comando da qualunque nodo:
ha-manager crm-command node-maintenance enable NOMENODO
# aggiornamenti, firmware, riavvio
ha-manager crm-command node-maintenance disable NOMENODO
Lavora su un nodo alla volta: con due nodi offline contemporaneamente, un cluster da tre perde il quorum.
Per una manutenzione che coinvolge tutto il cluster, come la sostituzione degli switch della rete Corosync, la versione 9.2 ha aggiunto disarm-ha. Il comando sospende il controllo dell'HA e rilascia i watchdog, così nessun nodo si riavvia per la perdita temporanea del quorum:
ha-manager crm-command disarm-ha freeze
# lavori sulla rete del cluster
ha-manager crm-command arm-ha
Con freeze le risorse restano congelate dove sono; con ignore vengono escluse dalla gestione dell'HA finché non la riattivi.
Progettare il cluster con Rackone
Rackone è Proxmox Gold Partner e Proxmox Authorized Training Partner. Per un cluster Proxmox VE nuovo o da ampliare progettiamo la topologia (due nodi con QDevice, tre nodi, multinodo), lo storage, la segregazione delle reti e la configurazione dell'alta disponibilità con fencing e politiche di failover. Prima dell'installazione consegniamo un progetto documentato. Il quadro dei servizi è nella pagina Cluster Proxmox e alta disponibilità.
I valori e i comandi di questa guida fanno riferimento alla documentazione di Proxmox VE 9.x consultata a ottobre 2026: prima di applicarli verifica la guida della release che installi.
Scritto da Rackone